Logstash grok 教學:用 Pattern 解析 Log,附 Snort 告警完整範例


原始 Log 通常是一整行文字,直接丟進 Elasticsearch 很難搜尋與統計。Logstash 的 grok 過濾器可以用預先定義好的 Pattern,把一行 Log 拆成 IP、時間、訊息等獨立欄位,是建置 ELK 日誌分析平台時最常用的技巧。這篇用 Snort 的告警 Log 當範例,一步步示範怎麼寫 grok Pattern。
grok 基本語法與拆解範例
Logstash常使用grok語法來解析資料,可以再匯入其它平台之前對資料做拆分,建立正確的格式。
grok是使用以下的方式處理log,pattern就是你希望解析後的格式,tag就是你取的名字
%{PATTERN:tag}可以到這個網址去實作https://grokdebugger.com/
Pattern
| NUMBER | 處理數字 |
| DATA | 處理字串 |
| NOTSPACE | 非空格內容 |
| IP | 處理IPv4 or IPv6 |
| MONTHNUM | 處理月份 |
| MONTHDAY | 處理日 |
| TIME | 處理時間 |
| GREEDYDATA | 處理多個字串除了換行 |
假設今天有一段log
04/18-00:59:45.385191 [**] 起始的04是月份,所以我們使用%{MONTHNUM:month},請記住pattern要使用大寫。
再來遇到一個”/”,log中不相關的內容我們就可以照抄,不過要注意有些字元需要使用”\”跳脫,例如”[“, “]”,一個簡單的小技巧就是如果不確定需不需要跳脫,都加”\”就好了。
所以我們parse的內容就會變成
%{MONTHNUM:month}/接下來18是日期,所以使用%{MONTHDAY:day},遇到了一個無關的”-“
%{MONTHNUM:month}/%{MONTHDAY:day}-再來00:59:45.385191剛好可以直接被TIME這個pattern match,所以結果是
%{MONTHNUM:month}/%{MONTHDAY:day}-%{TIME:time}最後遇到一個空格還有[**],剛剛提到”[]”這兩個都需要跳脫,另外兩個星星其實在這個log中沒什麼意義,你可以選擇照打,也可以給他一個pattern但不給他tag,這樣parse後的結果就不會出現,等於我們忽略掉了。我們使用DATA這個pattern來給**。
最終的結果
%{MONTHNUM:month}/%{MONTHDAY:day}-%{TIME:time} \[%{DATA}\]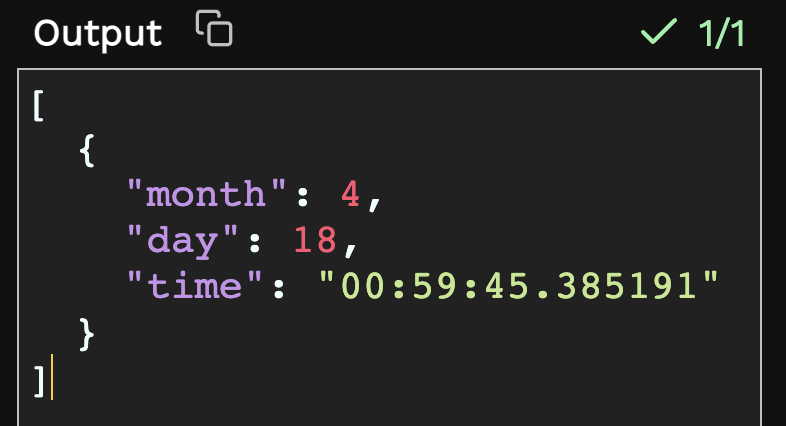
完整範例:解析 Snort alert_fast 告警
以下是一行典型的 Snort 告警,以及對應的完整 grok Pattern,可以一次拆出時間、規則編號、訊息、協定與來源/目的 IP:
04/18-00:59:45.385191 [**] [1:1000001:1] ICMP Ping detected [**] [Priority: 0] {ICMP} 192.168.1.10 -> 192.168.1.20%{MONTHNUM:month}/%{MONTHDAY:day}-%{TIME:time}\s+\[\*\*\] \[%{INT:gid}:%{INT:sid}:%{INT:rev}\] %{DATA:msg} \[\*\*\] \[Priority: %{INT:priority}\] \{%{WORD:proto}\} %{IP:src_ip}(?::%{INT:src_port})? -> %{IP:dst_ip}(?::%{INT:dst_port})?放進 Logstash 設定檔中:
input {
  file {
    path => "/var/log/snort/alert_fast.txt"
    start_position => "beginning"
  }
}

filter {
  grok {
    match => { "message" => "<上面的 Pattern>" }
  }
}

output {
  elasticsearch {
    hosts => ["http://localhost:9200"]
    index => "snort-%{+YYYY.MM.dd}"
  }
  stdout { codec => rubydebug }
}
TCP / UDP 告警會帶連接埠,ICMP 則沒有,所以 Pattern 中的連接埠用 (?: ... )? 設為可選。
除錯技巧
- Kibana Grok Debugger:Kibana 的 Dev Tools 內建 Grok Debugger,貼上 Log 與 Pattern 就能即時看到解析結果
- 由左而右逐段寫:先只寫第一個欄位,確認能匹配再往後加,比一次寫完整條好除錯
- 看
_grokparsefailure標籤:解析失敗的事件會被加上這個 tag,可以用來篩出格式不符的 Log - 少用 GREEDYDATA:放在中間會吃掉後面的內容,盡量只放在最後一個欄位
常見問題
DATA 和 GREEDYDATA 差在哪?
兩者都匹配任意字元,DATA 是「非貪婪」比對,遇到後面的固定字元就停;GREEDYDATA 會盡量吃到行尾。夾在中間的欄位用 DATA,最後剩下的內容才用 GREEDYDATA。
內建 Pattern 不夠用怎麼辦?
可以直接在 grok 中用正規表示式自訂,例如 (?<session_id>[A-F0-9]{16}),或用 pattern_definitions 定義可重複使用的自訂 Pattern。